API-infrastruktur och backendutveckling

Svenska

Referensscenarier

Arkitektoniska referensscenarier och implementationsmönster

Åtta återkommande infrastrukturproblem och de mönster vi använder för att lösa dem. Varje scenario beskriver felmoden, det tekniska angreppssättet och hur framgång mäts.

ObsFöljande referensscenarier illustrerar etablerade arkitekturmönster, metoder för systemdesign och tekniska målnivåer för att lösa infrastrukturflaskhalsar vid hög samtidighet.

01

Edge-routing med hög genomströmning och anslutningspooler

API-gateways och edge-infrastruktur
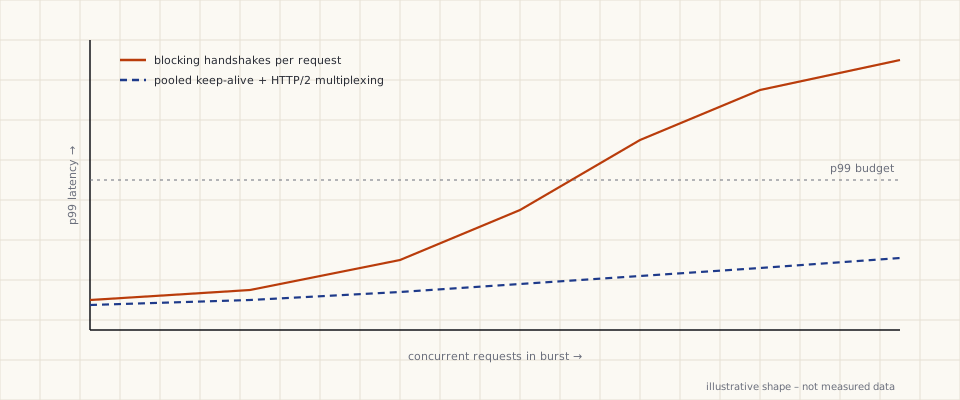
Diagram: Edge-routing med hög genomströmning och anslutningspooler

Arkitektonisk flaskhals

Plötsliga samtidiga webhook-skurar driver p99-latensen långt över budget. Varje anrop öppnar en ny uppströmsanslutning, så TCP- och TLS-handskakningar, brist på kortlivade portar och blockerande hantering staplas just när trafiken toppar.

Tekniskt angreppssätt

  1. Terminera klientanslutningar i en asynkron edge-proxy och håll varma keep-alive-pooler mot varje uppström, dimensionerade efter toppsamtidighet.
  2. Använd HTTP/2-multiplexering mot uppströmmar som stöder det, så att skurar delar anslutningar i stället för att öppna nya.
  3. Dirigera på huvuden utan att buffra kroppar; begränsa kroppsstorlek per route och strömma innehållet vidare.
  4. Begränsa köer och sätt tidsgränser per route så att överlast avvisas tidigt med 503 och Retry-After i stället för att låsa sig.

Hur framgång mäts

  • p95/p99-latens vid kanten per route inom överenskommen budget i syntetiska skurtester
  • Återanvändningsgrad för uppströmsanslutningar och andel nya handskakningar under skurar
  • Inga tappade eller återställda anslutningar vid målskurstorleken
  • Kötid vid kanten redovisas separat från uppströmstid
02

Stegvis uppdelning av en monolit (strangler fig)

Modernisering av äldre system
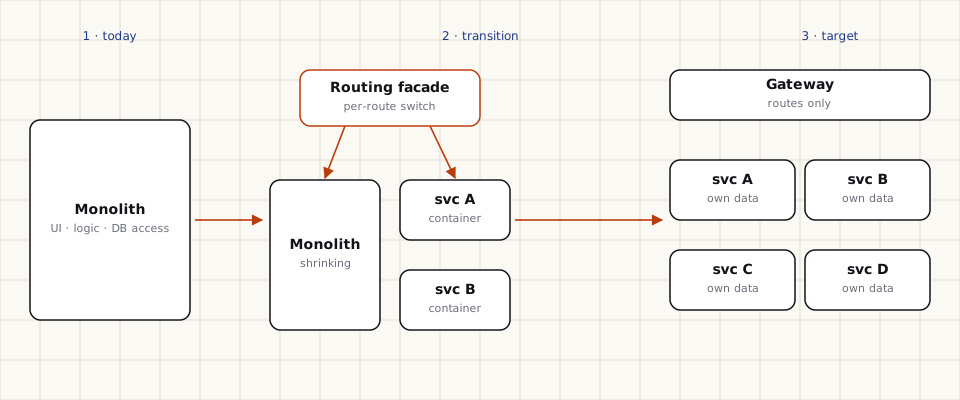
Diagram: Stegvis uppdelning av en monolit (strangler fig)

Arkitektonisk flaskhals

En tätt kopplad PHP-monolit blandar affärslogik med databasåtkomst. Varje driftsättning berör allt, en regression i en modul kan fälla hela systemet och ingen del kan skalas för sig.

Tekniskt angreppssätt

  1. Placera en routingfasad framför monoliten så att enskilda routes kan växlas utan ändringar hos klienterna.
  2. Fånga nuvarande beteende med karakteriseringstester innan en förmåga bryts ut.
  3. Bryt ut en avgränsad domän i taget till en egen container och håll sessions- och datakontrakt kompatibla under övergången.
  4. Kör först i skuggläge, flytta sedan trafiken gradvis per route och ta bort gammal kod när den nya vägen har bevisat sig.

Hur framgång mäts

  • Driftsättningsfrekvens per utbruten tjänst, oberoende av monoliten
  • Oberoende horisontell skalning av utbrutna containrar under last
  • Övergång utan driftstopp per migrerad route, verifierad med resultat från skuggjämförelser
  • Gammal kod och tabeller som faktiskt har tagits bort
03

Tillståndslös, strömmande parsning av XML och strukturerade data

Datapipelines med stora volymer
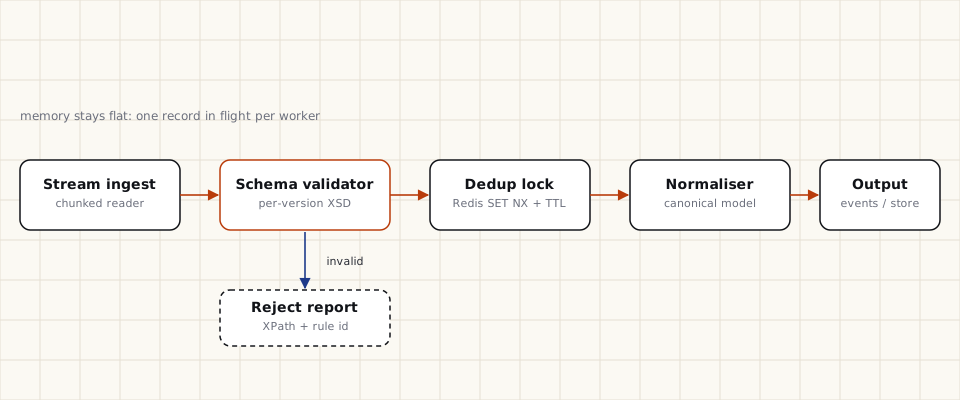
Diagram: Tillståndslös, strömmande parsning av XML och strukturerade data

Arkitektonisk flaskhals

DOM-baserad parsning av stora, djupt nästlade XML- och ISO 20022-meddelanden läser in hela dokument i minnet. Vid ihållande genomströmning når arbetsprocesserna minnesgränser, processorn mättas och en felaktig fil kan stoppa en hel batch.

Tekniskt angreppssätt

  1. Läs dokument med en härdad pull-parser (inga DTD:er, inga externa entiteter) och bearbeta en post i taget.
  2. Validera varje post mot den schemaversion den anger, med förkompilerade validerare.
  3. Deduplicera med ett kortlivat distribuerat lås per meddelande-ID, till exempel SET NX med TTL i Redis.
  4. Normalisera till en kanonisk modell, publicera vidare och lägg avvisade poster i karantän med en maskinläsbar rapport.

Hur framgång mäts

  • Stabilt minne per arbetsprocess oavsett filstorlek
  • Ihållande antal meddelanden per sekund vid målvolymen
  • Deterministisk validering: samma indata ger alltid samma godkännande eller avvisning
  • Andel undertryckta dubbletter och karantänvolym per avsändare
04

Zero trust-identitet för arbetslaster och avsändarbundna token

Säkerhet mellan tjänster
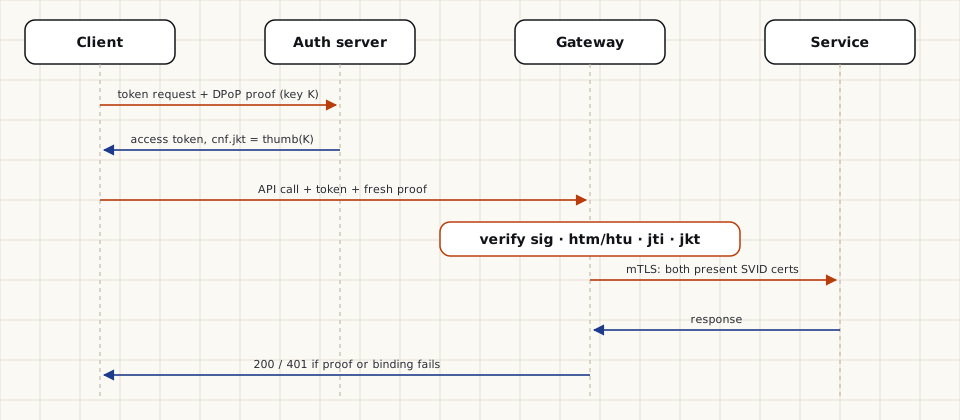
Diagram: Zero trust-identitet för arbetslaster och avsändarbundna token

Arkitektonisk flaskhals

Interna tjänster litar på nätverket och autentiserar med statiska API-nycklar eller långlivade JWT:er. En läckt token kan återanvändas, och en komprometterad arbetslast kan röra sig i sidled till vilket internt API som helst.

Tekniskt angreppssätt

  1. Utfärda kortlivade X.509-identiteter (SPIFFE ID) till varje tjänst och rotera dem automatiskt.
  2. Kräv ömsesidig TLS för all öst-västlig trafik och gå från tillåtande till strikt läge namnrymd för namnrymd.
  3. Bind åtkomsttoken till klientnycklar med DPoP i gatewayen, med en delad replay-cache för bevisidentifierare.
  4. Lägg till auktoriseringsregler per arbetslastidentitet som nekar som standard.

Hur framgång mäts

  • Andel öst-västlig trafik över ömsesidig TLS (mål: all)
  • Rotationsintervall för certifikat och andel misslyckade förnyelser
  • Avvisning av obundna, utgångna eller återspelade token i automatiska tester
  • Nekanden från auktoriseringsregler granskade och förklarade
05

Adaptiv hastighetsbegränsning och beteendebaserad avvikelsefiltrering vid kanten

Trafikstyrning och motståndskraft vid kanten
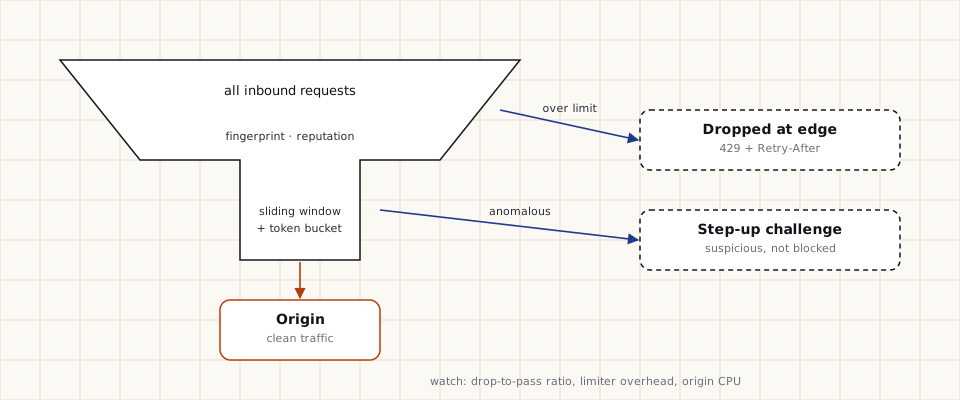
Diagram: Adaptiv hastighetsbegränsning och beteendebaserad avvikelsefiltrering vid kanten

Arkitektonisk flaskhals

Automatiserad skrapning, credential stuffing och skurig icke-mänsklig trafik når ursprungsservern ofiltrerad. Databasens arbetsprocesser mättas, legitima användare får timeouts och kapacitet läggs på anrop som aldrig borde ha kommit fram.

Tekniskt angreppssätt

  1. Fingeravtryck anrop vid kanten (klientidentitet, nätverk, beteende) och håll räknare i en delad minnesbaserad lagring.
  2. Använd token buckets för att tåla skurar och glidande fönster för strikta periodgränser, per klient, konto och route.
  3. Svara 429 med Retry-After på trafik över gränsen och en extra kontroll på misstänkt men osäker trafik.
  4. Visa samma innehåll för alla besökare; filtret avgör bara om ett anrop släpps igenom.

Hur framgång mäts

  • Förhållandet mellan anrop som stoppas vid kanten och anrop som når ursprunget under toppar
  • Tillägg för utvärdering av gränser vid p99 (mål: under en millisekund)
  • Stabil processorlast i ursprungsdatabasen vid trafiktoppar
  • Andel falska positiva, mätt via genomförda kontroller och supportärenden
06

Active-active över flera regioner med automatiserad återställning

Hög tillgänglighet och operativ motståndskraft
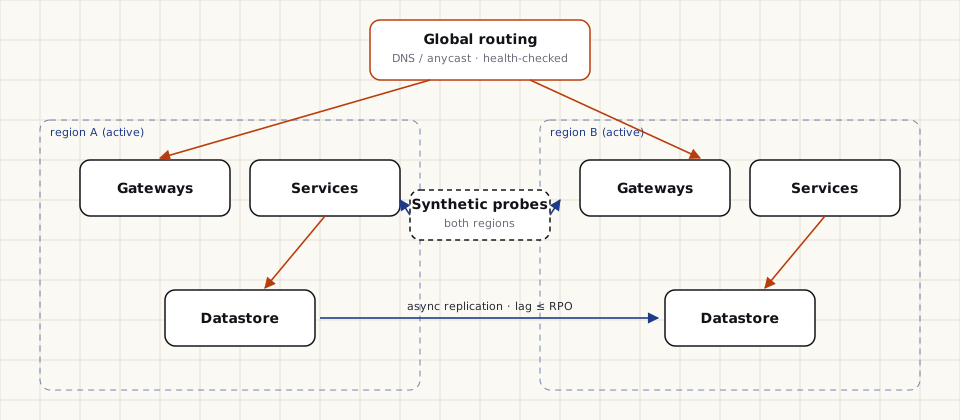
Diagram: Active-active över flera regioner med automatiserad återställning

Arkitektonisk flaskhals

Återställning förutsätter att någon märker avbrottet och ändrar DNS manuellt. Vid en regional nätverksdelning eller försämrad zon drar återställningstiden ut långt över vad verksamheten kan acceptera.

Tekniskt angreppssätt

  1. Kör båda regionerna aktiva, var och en dimensionerad för att bära hela topplasten ensam.
  2. Replikera tillstånd asynkront och övervaka replikeringsfördröjningen kontinuerligt mot överenskommen RPO.
  3. Testa båda regionerna med syntetiska transaktioner och styr trafiken automatiskt via hälsokontrollerad DNS eller anycast.
  4. Öva regionbortfall i kaosövningar och håll körbara handböcker för befordran av tillståndsbärande komponenter.

Hur framgång mäts

  • Replikeringsfördröjning under RPO-gränsen, med larm vid överskridande
  • Total failover-tid i övningar jämfört med RTO
  • Felfrekvens som syntetiska tester ser under failover
  • Handbokens steg utförda utan improvisation
07

Transactional outbox och idempotent händelseströmning

Konsistens i distribuerade data
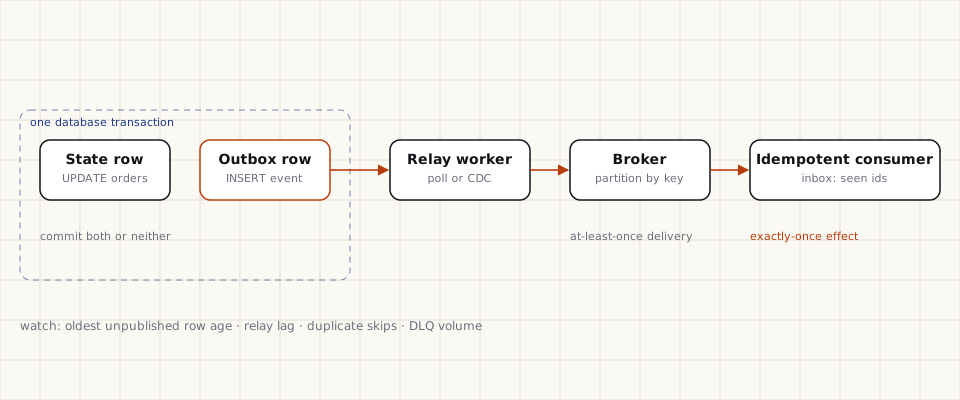
Diagram: Transactional outbox och idempotent händelseströmning

Arkitektonisk flaskhals

Tjänsterna skriver till PostgreSQL och publicerar till en meddelandemäklare i två separata steg. En krasch eller ett mäklaravbrott mellan dem tappar händelser eller annonserar ändringar som aldrig sparades, och tillståndet nedströms glider isär.

Tekniskt angreppssätt

  1. Skriv tillståndsändringen och en outbox-rad i samma databastransaktion.
  2. Publicera outbox-rader med en asynkron relä (pollning eller change data capture), partitionerat per aggregatnyckel för att bevara ordningen per entitet.
  3. Gör varje konsument idempotent med en inkorgstabell över behandlade händelse-ID:n.
  4. Skicka upprepat misslyckade händelser till ett dead letter-ämne med tillräcklig kontext för att spela upp dem igen.

Hur framgång mäts

  • Ingen glidning mellan tillstånd och händelser efter simulerade mäklaravbrott
  • Reläfördröjning, mätt som åldern på den äldsta opublicerade raden
  • Dubbletter som konsumenter hoppar över, räknade och larmade
  • Volym i dead letter-kön och tid till åtgärd
08

Latenskänslig autoskalning och flerspråkig edge-cachning

Molnorkestrering och prestanda
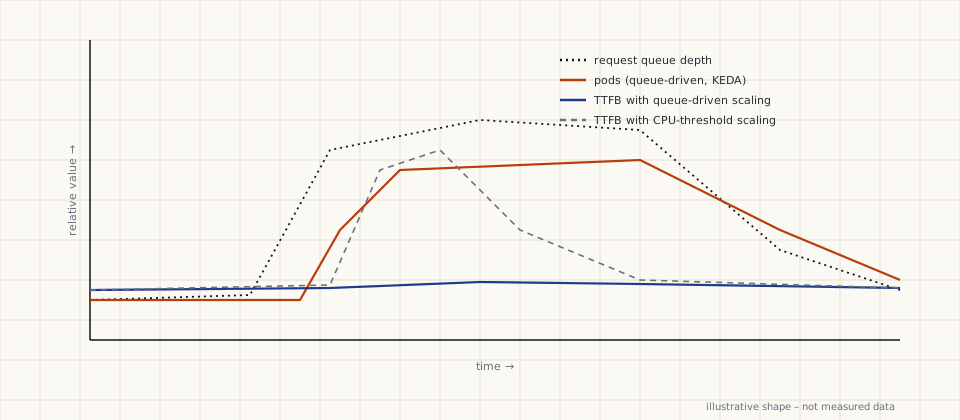
Diagram: Latenskänslig autoskalning och flerspråkig edge-cachning

Arkitektonisk flaskhals

Autoskalning baserad på processortrösklar reagerar först när anropen redan köar. I latenskritiska, flerspråkiga miljöer ökar plötsliga ramper tiden till första byte innan nya poddar är redo, och cachenycklar utan språk missar eller levererar fel språk.

Tekniskt angreppssätt

  1. Skala på köns djup och p95-latens med händelsedriven autoskalning (KEDA) i stället för enbart processorlast.
  2. Håll ledig nodkapacitet så att nya poddar schemaläggs direkt, och knyt beredskapen till uppvärmningen.
  3. Ta uttryckligen med språket i edge-cachenycklar för alla sex språk som stöds, med konsekventa Vary-regler.
  4. Ta bort snäva processorgränser på latenskritiska poddar för att undvika strypning.

Hur framgång mäts

  • Stabil tid till första byte (p95) under syntetiska trafikramper
  • Tid från växande kö till redo poddar
  • Träffgrad i edge-cachen per språk
  • Processorstrypning på latenskritiska poddar (mål: ingen)

Har du ett system som behöver skala eller bli säkrare?

Berätta om arkitekturen, flaskhalsen eller tidsplanen. Vi svarar via e-post och bokar en tid för ett avgränsningsmöte.

Boka konsultation