API-infrastruktur og backendutvikling

Norsk

Referansescenarioer

Arkitektoniske referansescenarioer og implementeringsmønstre

Åtte tilbakevendende infrastrukturproblemer og mønstrene vi bruker for å løse dem. Hvert scenario beskriver feilmodusen, den tekniske tilnærmingen og hvordan suksess måles.

MerkReferansescenarioene nedenfor illustrerer etablerte arkitekturmønstre, metoder for systemdesign og tekniske målnivåer for å løse infrastrukturflaskehalser ved høy samtidighet.

01

Edge-ruting med høy gjennomstrømning og tilkoblingspooler

API-gatewayer og edge-infrastruktur
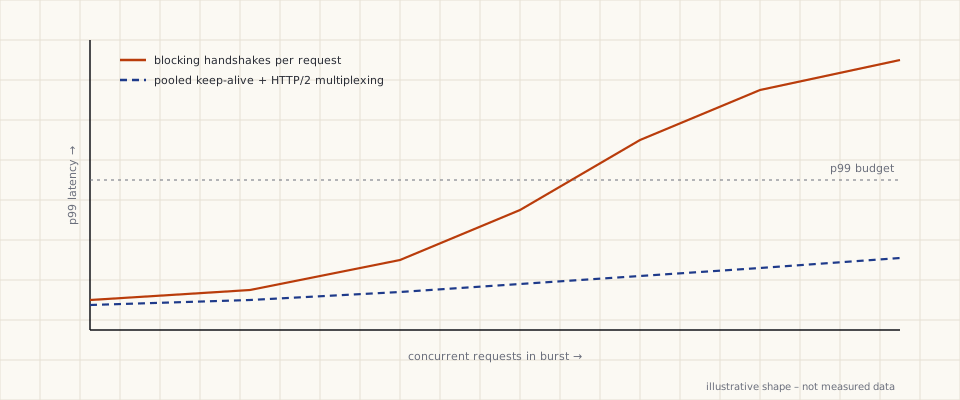
Diagram: Edge-ruting med høy gjennomstrømning og tilkoblingspooler

Arkitektonisk flaskehals

Plutselige samtidige webhook-utbrudd presser p99-latensen langt over budsjett. Hver forespørsel åpner en ny oppstrømstilkobling, så TCP- og TLS-håndtrykk, mangel på kortlevde porter og blokkerende håndtering hoper seg opp nettopp når trafikken topper seg.

Teknisk tilnærming

  1. Terminer klienttilkoblinger i en asynkron edge-proxy og hold varme keep-alive-pooler mot hver oppstrøm, dimensjonert etter toppsamtidighet.
  2. Bruk HTTP/2-multipleksing mot oppstrømmer som støtter det, slik at utbrudd deler tilkoblinger i stedet for å åpne nye.
  3. Rut på headere uten å bufre innholdet; begrens innholdsstørrelse per rute og strøm innholdet videre.
  4. Begrens køer og sett tidsavbrudd per rute slik at overbelastning avvises tidlig med 503 og Retry-After i stedet for å henge.

Slik måles suksess

  • p95/p99-latens i kanten per rute innenfor avtalt budsjett i syntetiske utbruddstester
  • Gjenbruksgrad for oppstrømstilkoblinger og andel nye håndtrykk under utbrudd
  • Ingen tapte eller nullstilte tilkoblinger ved målstørrelsen på utbrudd
  • Køtid i kanten rapportert separat fra oppstrømstid
02

Gradvis oppdeling av en monolitt (strangler fig)

Modernisering av eldre systemer
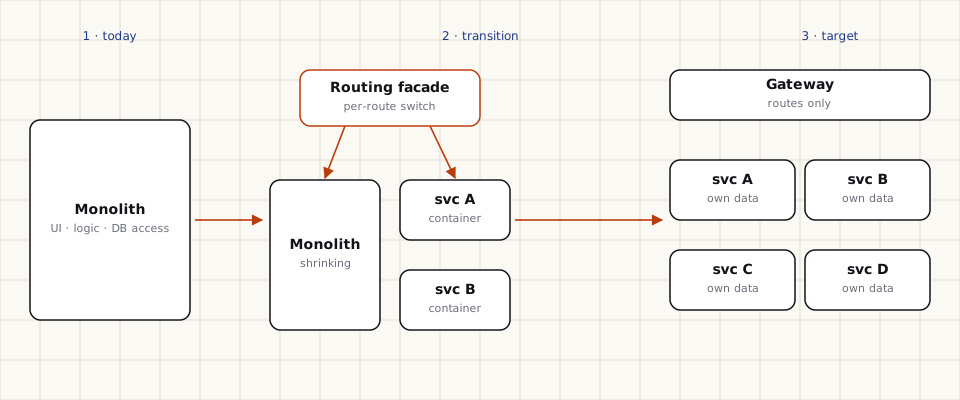
Diagram: Gradvis oppdeling av en monolitt (strangler fig)

Arkitektonisk flaskehals

En tett koblet PHP-monolitt blander forretningslogikk med databasetilgang. Hver utrulling berører alt, en regresjon i én modul kan ta ned hele systemet, og ingen del kan skaleres for seg.

Teknisk tilnærming

  1. Plasser en rutingfasade foran monolitten slik at enkeltruter kan byttes uten endringer hos klientene.
  2. Fang dagens atferd med karakteriseringstester før en funksjon skilles ut.
  3. Skill ut ett avgrenset domene om gangen til en egen container, og hold økt- og datakontrakter kompatible under overgangen.
  4. Kjør først i skyggemodus, flytt deretter trafikken gradvis per rute og slett gammel kode når den nye veien har bevist seg.

Slik måles suksess

  • Utrullingsfrekvens per utskilt tjeneste, uavhengig av monolitten
  • Uavhengig horisontal skalering av utskilte containere under last
  • Overgang uten nedetid per migrert rute, verifisert med resultater fra skyggesammenligning
  • Gammel kode og tabeller som faktisk er fjernet
03

Tilstandsløs, strømmende parsing av XML og strukturerte data

Datapipelines med store volumer
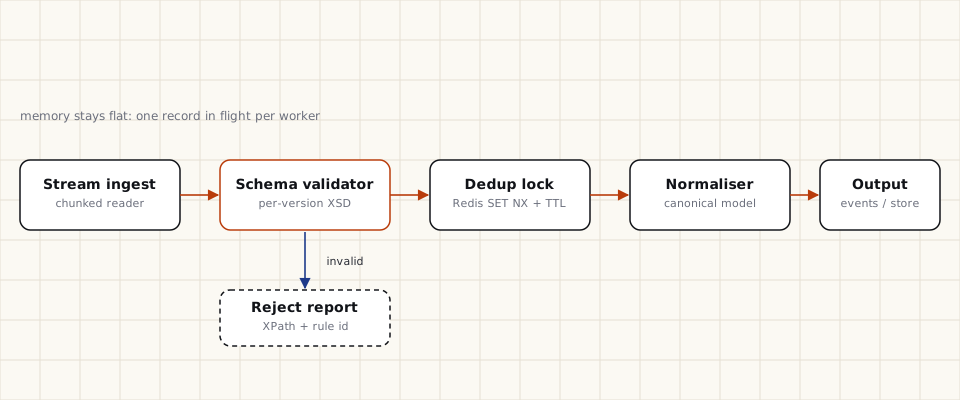
Diagram: Tilstandsløs, strømmende parsing av XML og strukturerte data

Arkitektonisk flaskehals

DOM-basert parsing av store, dypt nøstede XML- og ISO 20022-meldinger laster hele dokumenter inn i minnet. Ved vedvarende gjennomstrømning når arbeidsprosessene minnegrensene, prosessoren mettes og én feilaktig fil kan stoppe en hel batch.

Teknisk tilnærming

  1. Les dokumenter med en herdet pull-parser (ingen DTD-er, ingen eksterne entiteter) og behandle én post om gangen.
  2. Valider hver post mot skjemaversjonen den oppgir, med forhåndskompilerte validatorer.
  3. Dedupliser med en kortlevd distribuert lås per meldings-ID, for eksempel SET NX med TTL i Redis.
  4. Normaliser til en kanonisk modell, publiser videre og legg avviste poster i karantene med en maskinlesbar rapport.

Slik måles suksess

  • Stabilt minnebruk per arbeidsprosess uansett filstørrelse
  • Vedvarende antall meldinger per sekund ved målvolum
  • Deterministisk validering: samme inndata gir alltid samme godkjenning eller avvisning
  • Andel undertrykte duplikater og karantenevolum per avsender
04

Zero trust-identitet for arbeidslaster og avsenderbundne tokener

Sikkerhet mellom tjenester
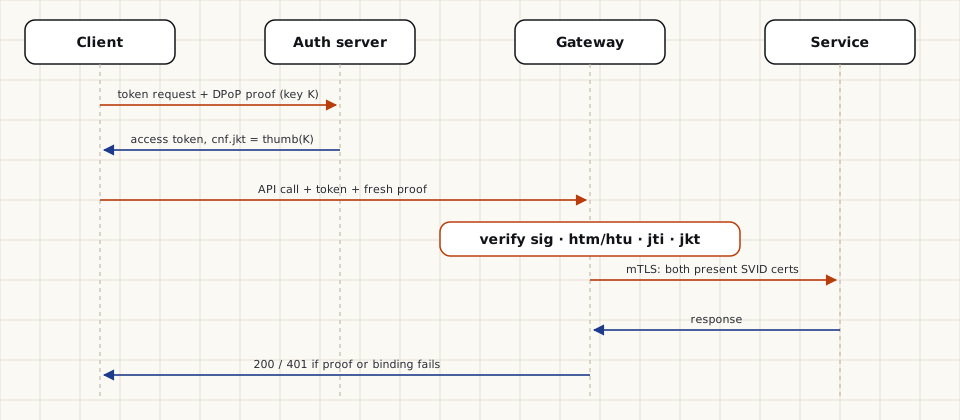
Diagram: Zero trust-identitet for arbeidslaster og avsenderbundne tokener

Arkitektonisk flaskehals

Interne tjenester stoler på nettverket og autentiserer med statiske API-nøkler eller langlivede JWT-er. Et lekket token kan gjenbrukes, og én kompromittert arbeidslast kan bevege seg sidelengs til et hvilket som helst internt API.

Teknisk tilnærming

  1. Utsted kortlevde X.509-identiteter (SPIFFE ID) til hver tjeneste og roter dem automatisk.
  2. Krev gjensidig TLS for all øst-vest-trafikk, og gå fra tillatende til streng modus navnerom for navnerom.
  3. Bind tilgangstokener til klientnøkler med DPoP i gatewayen, med en delt replay-hurtigbuffer for bevisidentifikatorer.
  4. Legg til autorisasjonsregler per arbeidslastidentitet som avviser som standard.

Slik måles suksess

  • Andel øst-vest-trafikk over gjensidig TLS (mål: all)
  • Rotasjonsintervall for sertifikater og andel mislykkede fornyelser
  • Avvisning av ubundne, utløpte eller gjenspilte tokener i automatiske tester
  • Avvisninger fra autorisasjonsregler gjennomgått og forklart
05

Adaptiv ratebegrensning og atferdsbasert avviksfiltrering i kanten

Trafikkstyring og robusthet i kanten
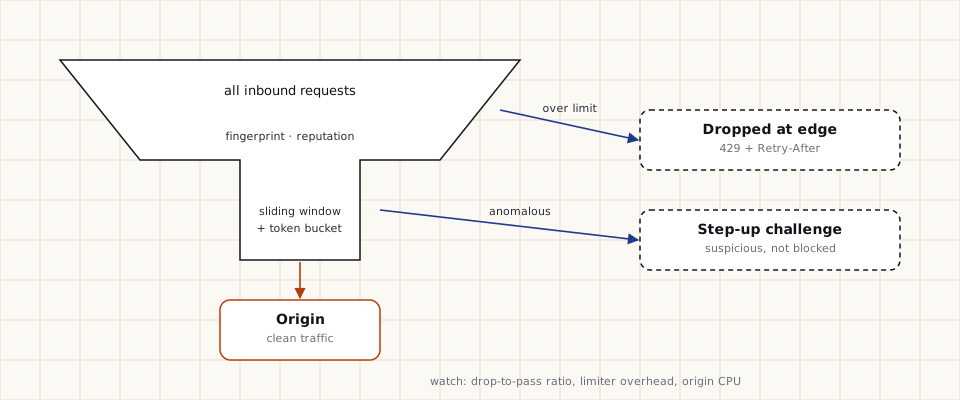
Diagram: Adaptiv ratebegrensning og atferdsbasert avviksfiltrering i kanten

Arkitektonisk flaskehals

Automatisert skraping, credential stuffing og ujevn ikke-menneskelig trafikk når opprinnelsesserveren ufiltrert. Databasens arbeidsprosesser mettes, legitime brukere får tidsavbrudd og kapasitet brukes på forespørsler som aldri burde kommet fram.

Teknisk tilnærming

  1. Lag fingeravtrykk av forespørsler i kanten (klientidentitet, nettverk, atferd) og hold tellere i en delt minnebasert lagring.
  2. Bruk token buckets for å tåle utbrudd og glidende vinduer for strenge periodegrenser, per klient, konto og rute.
  3. Svar 429 med Retry-After på trafikk over grensen og en ekstra kontroll på mistenkelig, men usikker trafikk.
  4. Vis samme innhold til alle besøkende; filteret avgjør bare om en forespørsel slippes gjennom.

Slik måles suksess

  • Forholdet mellom forespørsler stoppet i kanten og forespørsler sluppet til opprinnelsen under topper
  • Tillegg for evaluering av grenser ved p99 (mål: under ett millisekund)
  • Stabil prosessorbelastning i opprinnelsesdatabasen ved trafikktopper
  • Andel falske positive, målt gjennom gjennomførte kontroller og supporthenvendelser
06

Active-active over flere regioner med automatisert gjenoppretting

Høy tilgjengelighet og operasjonell robusthet
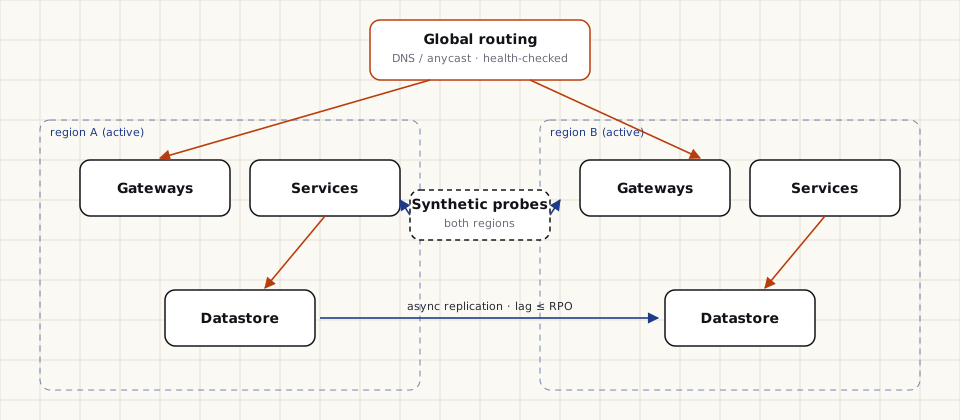
Diagram: Active-active over flere regioner med automatisert gjenoppretting

Arkitektonisk flaskehals

Gjenoppretting forutsetter at noen oppdager avbruddet og endrer DNS manuelt. Ved en regional nettverksdeling eller svekket sone drar gjenopprettingstiden ut langt over det virksomheten kan akseptere.

Teknisk tilnærming

  1. Kjør begge regionene aktive, hver dimensjonert til å bære hele topplasten alene.
  2. Repliker tilstand asynkront og overvåk replikeringsforsinkelsen kontinuerlig mot avtalt RPO.
  3. Test begge regionene med syntetiske transaksjoner og styr trafikken automatisk via helsekontrollert DNS eller anycast.
  4. Øv på regionbortfall i kaosøvelser og hold kjørbare håndbøker for opprykk av tilstandsbærende komponenter.

Slik måles suksess

  • Replikeringsforsinkelse under RPO-grensen, med varsling ved brudd
  • Total failover-tid i øvelser sammenlignet med RTO
  • Feilrate sett av syntetiske tester under failover
  • Håndbokens trinn utført uten improvisasjon
07

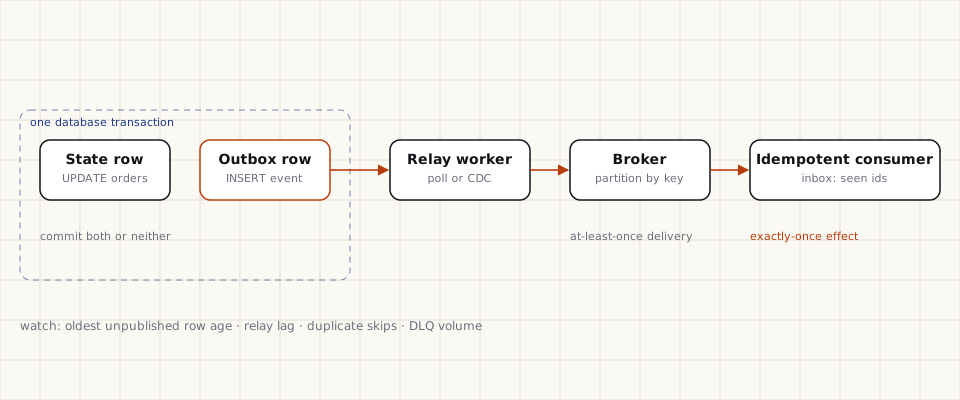
Transactional outbox og idempotent hendelsesstrømming

Konsistens i distribuerte data
Diagram: Transactional outbox og idempotent hendelsesstrømming

Arkitektonisk flaskehals

Tjenestene skriver til PostgreSQL og publiserer til en meldingsmegler i to separate trinn. Et krasj eller et meglerbrudd mellom dem mister hendelser eller kunngjør endringer som aldri ble lagret, og tilstanden nedstrøms glir fra hverandre.

Teknisk tilnærming

  1. Skriv tilstandsendringen og en outbox-rad i samme databasetransaksjon.
  2. Publiser outbox-rader med en asynkron relé (polling eller change data capture), partisjonert per aggregatnøkkel for å bevare rekkefølgen per entitet.
  3. Gjør hver konsument idempotent med en innbokstabell over behandlede hendelses-ID-er.
  4. Send hendelser som feiler gjentatte ganger til et dead letter-emne med nok kontekst til å spille dem av på nytt.

Slik måles suksess

  • Ingen avvik mellom tilstand og hendelser etter simulerte meglerbrudd
  • Reléforsinkelse, målt som alderen på den eldste upubliserte raden
  • Duplikater som konsumenter hopper over, telt og varslet
  • Volum i dead letter-køen og tid til løsning
08

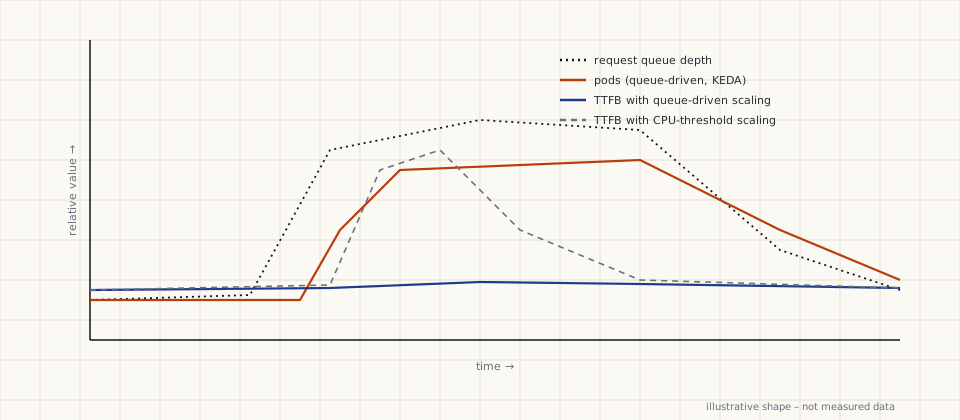
Latensfølsom autoskalering og flerspråklig edge-hurtigbuffer

Skyorkestrering og ytelse
Diagram: Latensfølsom autoskalering og flerspråklig edge-hurtigbuffer

Arkitektonisk flaskehals

Autoskalering basert på prosessorterskler reagerer først når forespørslene allerede står i kø. I latenskritiske, flerspråklige miljøer øker plutselige økninger tiden til første byte før nye pods er klare, og hurtigbuffernøkler uten språk bommer eller leverer feil språk.

Teknisk tilnærming

  1. Skaler på kødybde og p95-latens med hendelsesdrevet autoskalering (KEDA) i stedet for bare prosessorbelastning.
  2. Hold ledig nodekapasitet slik at nye pods planlegges umiddelbart, og knytt klarstatus til oppvarming.
  3. Ta eksplisitt med språket i edge-hurtigbuffernøkler for alle seks støttede språk, med konsekvente Vary-regler.
  4. Fjern stramme prosessorgrenser på latenskritiske pods for å unngå struping.

Slik måles suksess

  • Stabil tid til første byte (p95) under syntetiske trafikkøkninger
  • Tid fra økende kø til klare pods
  • Treffrate i edge-hurtigbufferen per språk
  • Prosessorstruping på latenskritiske pods (mål: ingen)

Har du et system som må skalere eller bli sikrere?

Fortell oss om arkitekturen, flaskehalsen eller tidsfristen. Vi svarer på e-post og avtaler et tidspunkt for et avklaringsmøte.

Bestill konsultasjon