Ingénierie d’infrastructure API et de systèmes back-end

Français

Scénarios de référence

Scénarios d’architecture de référence et modèles de mise en œuvre

Huit problèmes d’infrastructure récurrents et les modèles que nous utilisons pour les traiter. Chaque scénario décrit le mode de défaillance, l’approche d’ingénierie et la façon de mesurer le succès.

NoteLes scénarios de référence ci-dessous illustrent des modèles d’architecture éprouvés, des méthodes de conception de systèmes et des niveaux cibles d’ingénierie pour résoudre les goulets d’étranglement d’infrastructure à forte concurrence.

01

Routage en périphérie à haut débit et pools de connexions

Passerelles API et infrastructure de périphérie
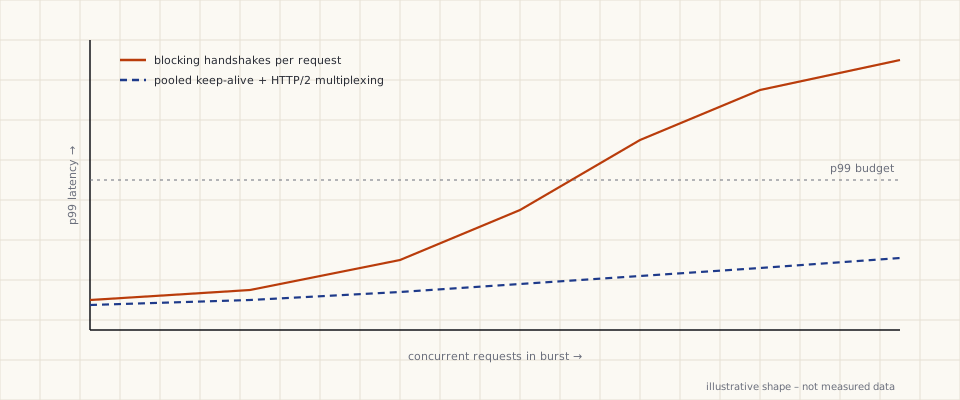
Schéma: Routage en périphérie à haut débit et pools de connexions

Goulet d’étranglement

Des rafales soudaines de webhooks simultanés poussent la latence p99 bien au-delà du budget. Chaque requête ouvre une nouvelle connexion amont : les poignées de main TCP et TLS, la pénurie de ports éphémères et le traitement bloquant s’accumulent précisément au pic de trafic.

Approche d’ingénierie

  1. Terminer les connexions clientes sur un proxy de périphérie asynchrone et maintenir vers chaque service amont des pools keep-alive chauds, dimensionnés selon la concurrence de pointe.
  2. Utiliser le multiplexage HTTP/2 vers les services amont qui le prennent en charge, afin que les rafales partagent les connexions au lieu d’en ouvrir de nouvelles.
  3. Router sur les en-têtes sans mettre les corps en mémoire tampon ; plafonner la taille des corps par route et les transmettre en flux.
  4. Borner les files d’attente et fixer des délais par route pour rejeter tôt la surcharge avec 503 et Retry-After plutôt que de bloquer.

Mesure du succès

  • Latence p95/p99 en périphérie par route dans le budget convenu lors de tests de rafales synthétiques
  • Taux de réutilisation des connexions amont et part de nouvelles poignées de main pendant les rafales
  • Aucune connexion perdue ou réinitialisée à la taille de rafale cible
  • Temps d’attente en périphérie mesuré séparément du temps amont
02

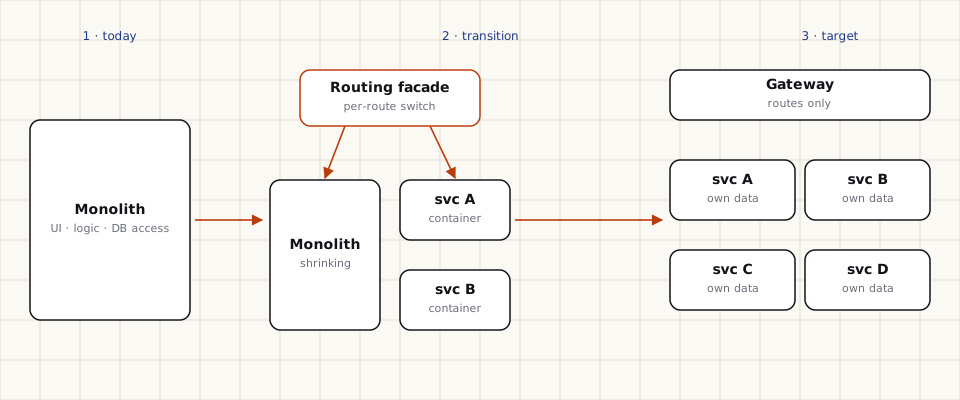
Décomposition progressive d’un monolithe (strangler fig)

Modernisation des systèmes existants
Schéma: Décomposition progressive d’un monolithe (strangler fig)

Goulet d’étranglement

Un monolithe PHP fortement couplé mélange logique métier et accès aux données. Chaque déploiement touche tout, une régression dans un module peut faire tomber l’ensemble du système et aucune partie ne peut monter en charge seule.

Approche d’ingénierie

  1. Placer une façade de routage devant le monolithe pour basculer des routes individuelles sans modifier les clients.
  2. Décrire le comportement actuel par des tests de caractérisation avant d’extraire une capacité.
  3. Extraire un domaine délimité à la fois dans son propre conteneur, en gardant les contrats de session et de données compatibles pendant la transition.
  4. Exécuter d’abord en mode ombre, puis basculer le trafic progressivement par route et supprimer l’ancien code une fois le nouveau chemin éprouvé.

Mesure du succès

  • Fréquence de déploiement de chaque service extrait, indépendamment du monolithe
  • Mise à l’échelle horizontale indépendante des conteneurs extraits sous charge
  • Bascule sans interruption par route migrée, vérifiée par les résultats de comparaison en mode ombre
  • Code et tables hérités effectivement supprimés
03

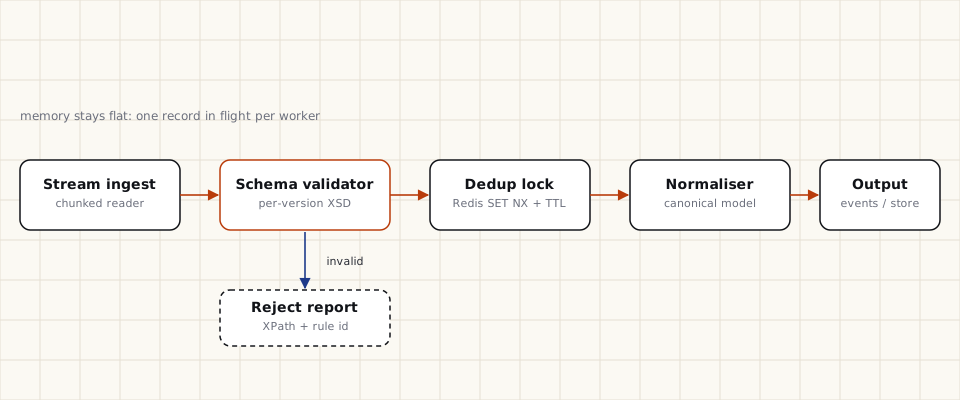
Analyse sans état et en flux de XML et de données structurées

Pipelines de données à fort volume
Schéma: Analyse sans état et en flux de XML et de données structurées

Goulet d’étranglement

L’analyse DOM de messages XML et ISO 20022 volumineux et profondément imbriqués charge des documents entiers en mémoire. Sous un débit soutenu, les processus de traitement atteignent leurs limites mémoire, le CPU sature et un seul fichier malformé peut bloquer tout un lot.

Approche d’ingénierie

  1. Lire les documents avec un analyseur pull renforcé (sans DTD ni entités externes) et traiter un enregistrement à la fois.
  2. Valider chaque enregistrement selon la version de schéma qu’il déclare, avec des validateurs précompilés.
  3. Dédupliquer à l’aide d’un verrou distribué de courte durée par identifiant de message, par exemple SET NX avec TTL dans Redis.
  4. Normaliser vers un modèle canonique, publier en aval et mettre en quarantaine les rejets avec un rapport lisible par machine.

Mesure du succès

  • Mémoire stable par processus, quelle que soit la taille des fichiers
  • Débit soutenu en messages par seconde au volume cible
  • Validation déterministe : une même entrée produit toujours la même acceptation ou le même rejet
  • Taux de doublons supprimés et volume de quarantaine par émetteur
04

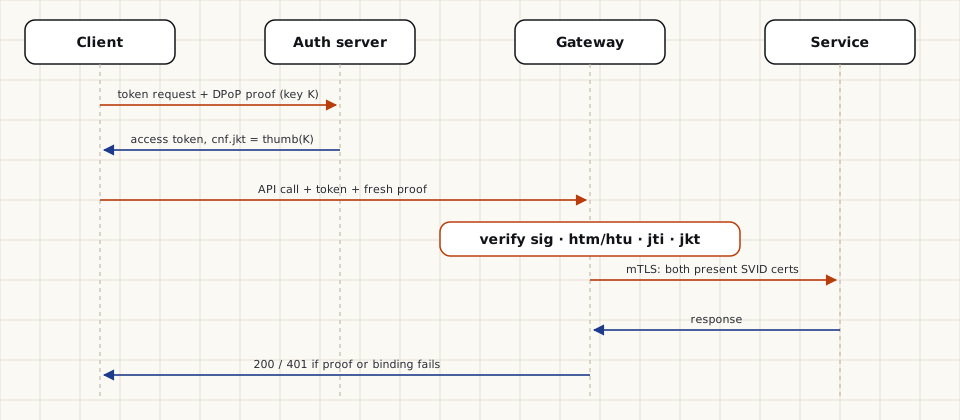
Identité de charge de travail zero trust et jetons liés à l’émetteur

Sécurité entre services
Schéma: Identité de charge de travail zero trust et jetons liés à l’émetteur

Goulet d’étranglement

Les services internes font confiance au réseau et s’authentifient avec des clés API statiques ou des JWT à longue durée de vie. Un jeton divulgué peut être rejoué, et une charge de travail compromise peut se déplacer latéralement vers n’importe quelle API interne.

Approche d’ingénierie

  1. Délivrer à chaque service une identité X.509 de courte durée (SPIFFE ID) et la renouveler automatiquement.
  2. Imposer le TLS mutuel pour tout le trafic est-ouest, en passant du mode permissif au mode strict espace de noms par espace de noms.
  3. Lier les jetons d’accès aux clés des clients avec DPoP sur la passerelle, avec un cache anti-rejeu partagé pour les identifiants de preuve.
  4. Ajouter des règles d’autorisation par identité de charge de travail, refusant par défaut.

Mesure du succès

  • Part du trafic est-ouest en TLS mutuel (objectif : la totalité)
  • Intervalle de rotation des certificats et taux d’échec de renouvellement
  • Rejet des jetons non liés, expirés ou rejoués dans les tests automatisés
  • Refus des règles d’autorisation examinés et expliqués
05

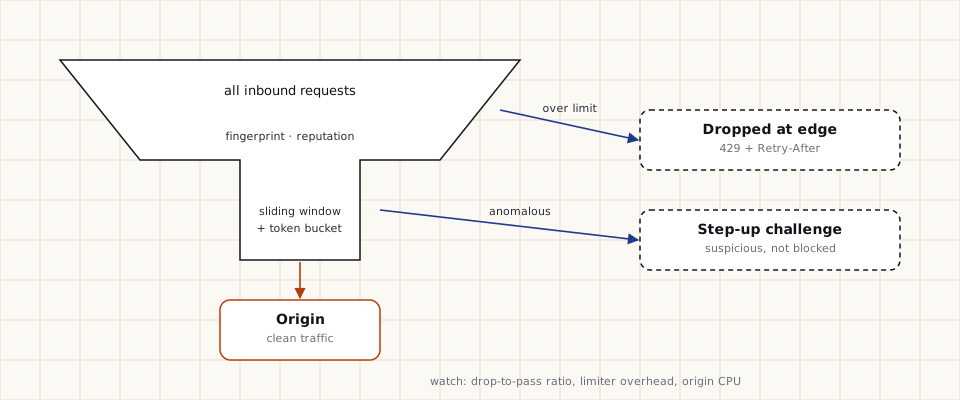
Limitation de débit adaptative et filtrage comportemental des anomalies en périphérie

Contrôle du trafic et résilience en périphérie
Schéma: Limitation de débit adaptative et filtrage comportemental des anomalies en périphérie

Goulet d’étranglement

Le scraping automatisé, le bourrage d’identifiants et les rafales de trafic non humain atteignent l’origine sans filtre. Les processus de la base de données saturent, les utilisateurs légitimes subissent des délais d’expiration et la capacité est consommée par des requêtes qui n’auraient jamais dû arriver.

Approche d’ingénierie

  1. Établir une empreinte des requêtes en périphérie (identifiant client, réseau, comportement) et tenir les compteurs dans un stockage partagé en mémoire.
  2. Appliquer des token buckets pour tolérer les rafales et des fenêtres glissantes pour des limites strictes par période, par client, compte et route.
  3. Répondre 429 avec Retry-After au trafic hors limite et proposer une vérification renforcée au trafic suspect mais incertain.
  4. Servir le même contenu à tous les visiteurs ; le filtre décide seulement si une requête passe.

Mesure du succès

  • Rapport entre requêtes rejetées en périphérie et requêtes transmises à l’origine pendant les pics
  • Surcoût d’évaluation des limites au p99 (objectif : moins d’une milliseconde)
  • Stabilité de la charge CPU de la base d’origine pendant les pics de trafic
  • Taux de faux positifs, mesuré à partir des vérifications réussies et des demandes d’assistance
06

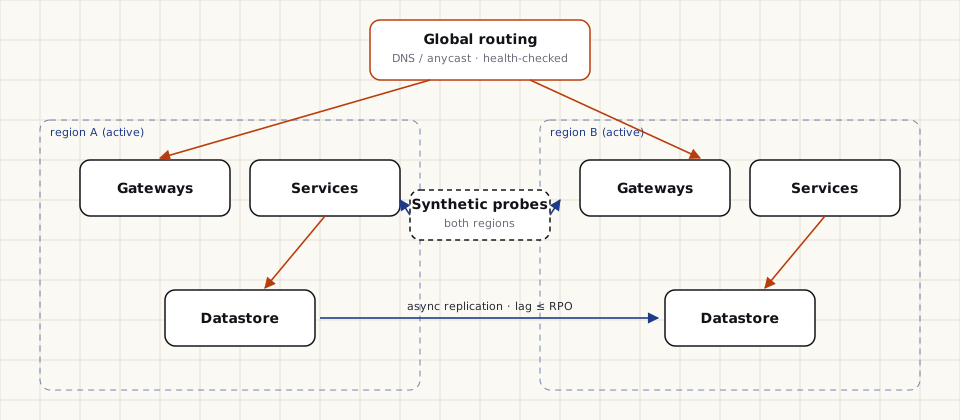
Bascule active-active multi-régions et reprise automatisée

Haute disponibilité et résilience opérationnelle
Schéma: Bascule active-active multi-régions et reprise automatisée

Goulet d’étranglement

La reprise dépend de quelqu’un qui remarque la panne et modifie le DNS à la main. Lors d’une partition réseau régionale ou de la dégradation d’une zone, le temps de reprise dépasse largement ce que le métier peut accepter.

Approche d’ingénierie

  1. Faire fonctionner les deux régions en actif, chacune dimensionnée pour porter seule toute la charge de pointe.
  2. Répliquer l’état de façon asynchrone et surveiller en continu le retard de réplication par rapport au RPO convenu.
  3. Sonder les deux régions avec des transactions synthétiques et orienter automatiquement le trafic via un DNS avec contrôles de santé ou un routage anycast.
  4. Répéter la perte d’une région lors d’exercices de chaos et maintenir des runbooks exécutables pour la promotion des composants à état.

Mesure du succès

  • Retard de réplication maintenu sous le seuil du RPO, avec alerte en cas de dépassement
  • Durée totale de bascule lors des exercices comparée au RTO
  • Taux d’erreur vu par les sondes synthétiques pendant la bascule
  • Étapes du runbook exécutées sans improvisation
07

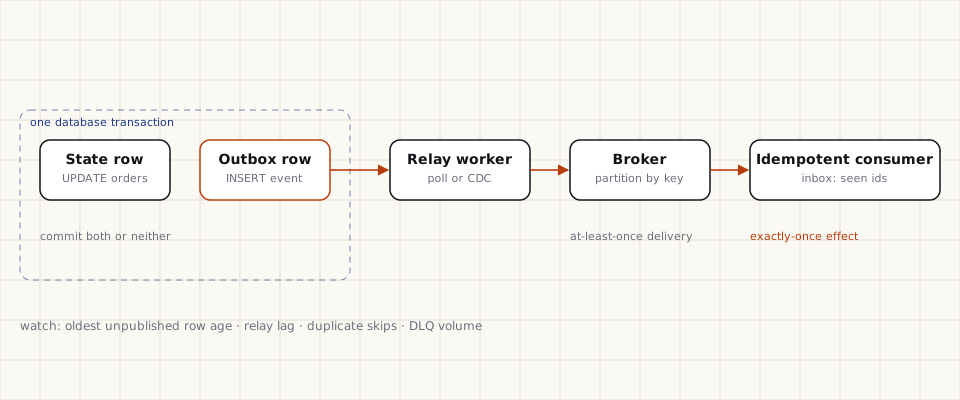
Transactional outbox et diffusion d’événements idempotente

Cohérence des données distribuées
Schéma: Transactional outbox et diffusion d’événements idempotente

Goulet d’étranglement

Les services écrivent dans PostgreSQL puis publient vers un broker en deux étapes distinctes. Un plantage ou une panne du broker entre les deux perd des événements ou annonce des changements jamais validés, et l’état en aval diverge.

Approche d’ingénierie

  1. Écrire le changement d’état et une ligne d’outbox dans la même transaction de base de données.
  2. Publier les lignes d’outbox avec un relais asynchrone (interrogation ou capture des changements), partitionné par clé d’agrégat pour préserver l’ordre par entité.
  3. Rendre chaque consommateur idempotent avec une table de réception des identifiants d’événements traités.
  4. Envoyer les événements en échec répété vers une file de rejet avec suffisamment de contexte pour les rejouer.

Mesure du succès

  • Aucune divergence entre état et événements après des pannes simulées du broker
  • Retard du relais, mesuré par l’âge de la plus ancienne ligne non publiée
  • Doublons ignorés par les consommateurs, comptés et alertés
  • Volume de la file de rejet et délai de résolution
08

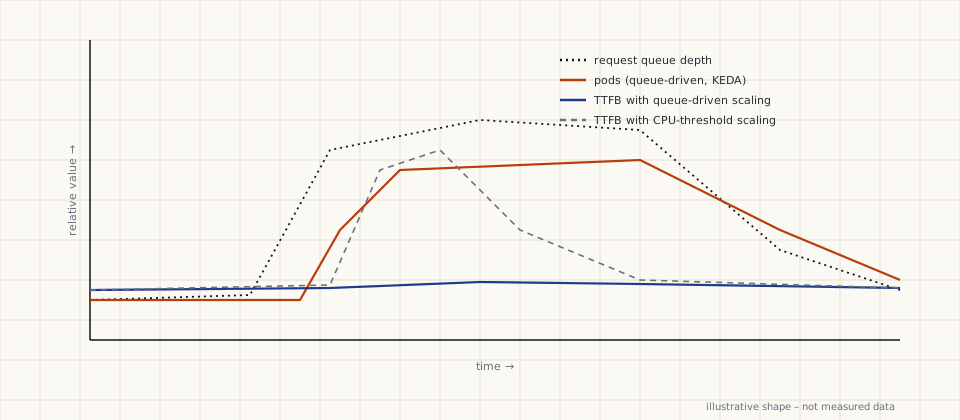
Mise à l’échelle automatique sensible à la latence et cache multilingue en périphérie

Orchestration cloud et performance
Schéma: Mise à l’échelle automatique sensible à la latence et cache multilingue en périphérie

Goulet d’étranglement

La mise à l’échelle fondée sur des seuils CPU ne réagit que lorsque les requêtes sont déjà en file d’attente. Dans des déploiements multilingues critiques en latence, les montées soudaines allongent le temps jusqu’au premier octet avant que les nouveaux pods soient prêts, et des clés de cache sans langue manquent le cache ou servent la mauvaise langue.

Approche d’ingénierie

  1. Mettre à l’échelle selon la profondeur de la file de requêtes et la latence p95 avec une mise à l’échelle pilotée par les événements (KEDA), et non selon le seul CPU.
  2. Conserver de la capacité libre sur les nœuds pour planifier immédiatement les nouveaux pods, et conditionner la disponibilité à la mise en température.
  3. Inclure explicitement la langue dans les clés de cache en périphérie pour les six langues prises en charge, avec des règles Vary cohérentes.
  4. Supprimer les limites CPU strictes sur les pods critiques en latence pour éviter l’étranglement.

Mesure du succès

  • Stabilité du temps jusqu’au premier octet (p95) lors de montées de trafic synthétiques
  • Délai entre la croissance de la file et la disponibilité des pods
  • Taux de succès du cache en périphérie par langue
  • Étranglement CPU des pods critiques en latence (objectif : aucun)

Un système doit monter en charge ou être mieux sécurisé ?

Parlez-nous de l’architecture, du goulet d’étranglement ou de l’échéance. Nous répondons par e-mail pour convenir d’un créneau de cadrage.

Réserver une consultation